今天和同事聊了聊公司在建的数据底座,回来把想法整理了一下。
眼下有三个很具体的观察:数据中台建了,但谁也不知道它在哪里、现在具体怎么样了;知识库开始搞了,可就是几个 IT 专家在弄,也没有结合具体的业务场景;至于数据湖、数据仓库,公司里根本没几个人能专业地讲清楚。
而我们现在正在建设的,是设计的数据底座——面向设计场景、由业务问题驱动的那一种。这和前面这几件事走的不是同一套路子:一个从技术出发,买平台、搭架构;一个从设计选型的实际问题出发,反过来要求数据能连得上、解释得了、验证得过、复用得起来。套路不同,长出来的东西自然也不同。
先把盘子的事说清楚
不管上面的模型、AI、知识库最后做成什么样,有一件事我认为无论如何都得先做起来——把承载数据的那套功能建起来。打个比方说:
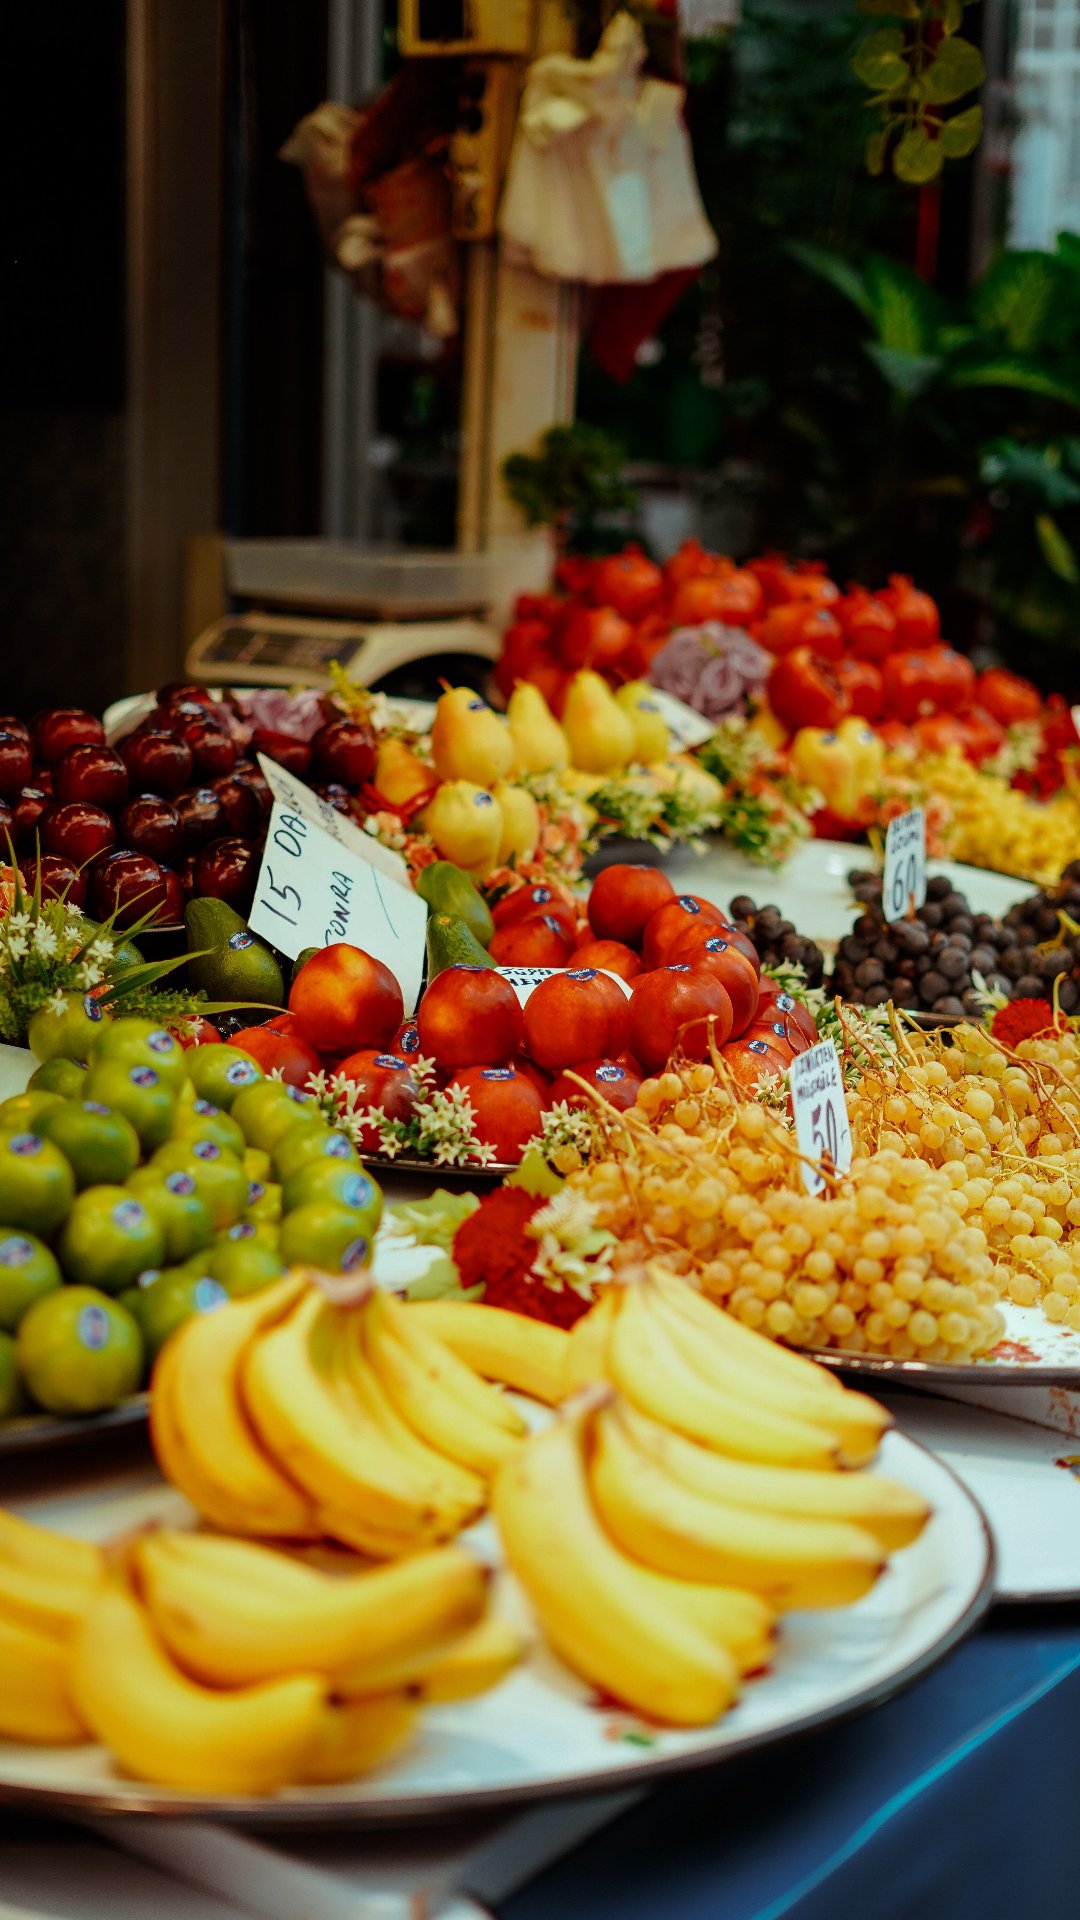
我们要去采果子,总得先有个盘子,把所有类型的果子都放得进去。有了这个盘子,所有人才能坐到一起来说清楚这么几件事:
- 我们到底要采什么样的果子——哪些数据是我们要的,先列明白;
- 什么果子已经采到了——手上有哪些数据,放在哪儿,谁在管;
- 什么果子还缺着——缺口在哪,是压根没采,还是采了没打通;
- 什么样的果子算好果子——达到什么标准才能放进来,不行的就别收;
- 什么样的果子要扔掉——过期、报错、重复的,该清就得清出去;
- 这些果子之间是什么关系——哪几个果子是从同一棵树上来的,彼此怎么牵扯。
没有这个盘子,果子采回来照样散在各人手里,谁也说不清家底。有了它,采、选、存、用才有同一个地方说话。这篇后面讲的,基本都是围绕怎么把这个盘子真做出来。
01为什么我们要重新理解"数据底座"
做数字化和 AI 这些年,我们大概都有过这种落差感:系统越来越多,数据量越来越大,AI 工具也陆续上线,可一到设计选型、质量分析、工艺优化、业务决策,感觉还是不稳、还是没法复用。这个落差背后,往往不是少了哪一种软件,而是我们还没有一套能把数据、业务逻辑和实践经验串起来的基础体系。
前面那三个观察,就是这个落差的具象版本:中台建完了没人找得到,知识库做起来了接不上业务场景,湖仓买来了没人真懂。它们的共同点是——建设是"项目"驱动的,使用是"业务"驱动的,中间没有人负责把两者接起来。项目验收那天,往往就是它开始消失的那天。
第三点尤其值得补一句。数据湖、数据仓库没人讲得清,多半是因为大家从来没被系统地讲过"数据库到底是个什么东西"。与其在会上争半天,不如老老实实看一遍基础:
浏览器要求自动播放必须静音,要点一下音量才有声音。来源:IBM Technology
看完这一段,再回头听我们在会上说的那些词——数据接入、数据加工、数据服务、湖仓一体——大概就不至于只听懂一半了。
我们公司已经部署了 ERP、PLM、MES、QMS、LIMS、CRM 这些系统,分别管着资源、产品设计、生产执行、质量检验、实验室结果和客户业务。可系统有了,不等于数据形成了统一认知:同一个产品可能有好几套编码;设计版本和生产批次常常对不上;质量异常记下来了,却回不到对应的设计参数或工艺条件;资深工程师心里门儿清某种材料、结构、工艺为什么好用,却没把这个判断过程变成别人能复用的规则。
所以说,数据底座要干的不是把所有数据搬进一个地方,而是建一套机制:让数据能被一致地描述、可靠地关联、结合业务逻辑解释得通,再用实际结果一遍遍验证和改进。
说明一句:"数据底座"这个词,在行业和厂商之间并没有完全统一的技术边界。上面只是我自己用来理清思路的一个工作性定义,强调的是从"把数据汇起来"走到"把数据关系、业务解释、持续验证做起来"。它不意味着别的架构天然做不了数据建模或知识管理,只是提醒我们:动手之前,先想清楚最后要长出什么能力。
02数据底座和中台、湖仓、知识库,到底差在哪
这几个概念彼此有交集,但盯的问题其实不一样。判断我们是不是真有了数据底座的能力,别看采购了什么产品,要看数据能不能形成贯通业务、可验证、可复用的模型。
数据中台,解决的是数据怎么汇聚、治理和服务
它可能意味着跨系统的数据整合、标准化治理、共享服务和面向业务的数据供给。它可以建数据目录、主数据体系、指标体系、数据服务接口和权限治理机制,减少各部门重复造轮子。
这些能力当然是数据底座的重要组成部分。但光把数据汇聚好、服务化,并不自动意味着我们已经解释清了产品设计、工艺条件、质量结果和实际使用环境之间的因果或业务关系。能不能再往前一步,取决于它的数据模型、业务语义和验证机制有没有真正覆盖到那些场景。
数据湖仓,解决的是数据怎么存、怎么算、怎么分析
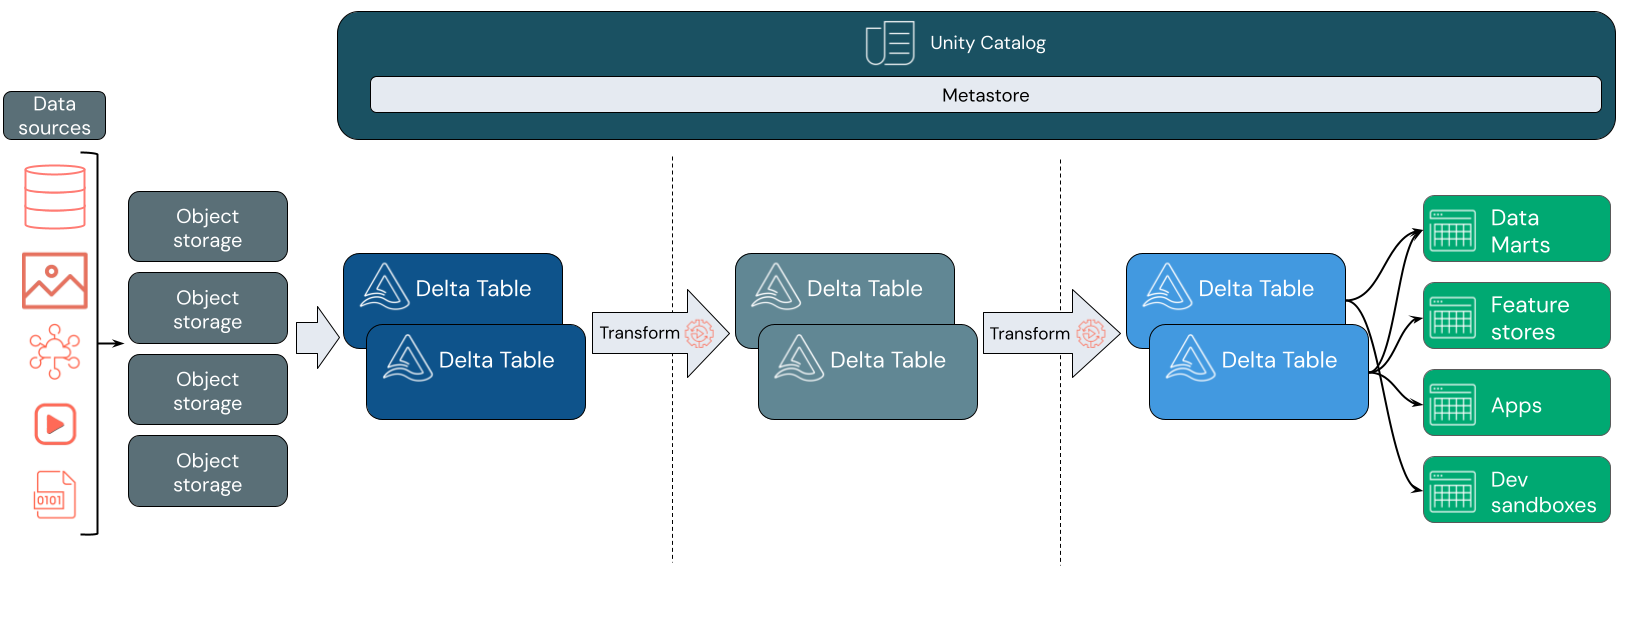
数据湖仓(Lakehouse),是把数据湖的灵活存储和数据仓库的管理、查询、分析能力合到一起,结构化、半结构化、部分非结构化都能吃,服务于数据工程、商业分析和机器学习这些活。
微软的 Azure Databricks 文档就是这么定位的。它是很强的技术底层,但技术架构自己不会长出工程知识:某个质量缺陷究竟对应哪个设计版本、哪组工艺参数、哪批原材料、哪种真实运行环境,还是得靠正确的标识、业务关系、分析方法和验证流程。
知识库,解决的是知识怎么存、怎么查、怎么用
知识库存的是制度、技术文档、故障案例、操作规程、专家经验和问答内容。接上搜索或大模型之后,员工找资料确实快了,也能给检索增强生成(RAG)这类应用当上下文。
但"搜到一段相关资料"和"建立可计算、可追溯、可验证的工程关系",不是一回事。文档可能只写了经验结论,没写清适用条件、参数范围、例外情况、数据依据和验证结果。对我们这种复杂产品和制造流程来说,还得把知识转成结构化规则、参数关系、模型、约束条件和适用边界,再拿实际数据互相校验。
数据底座,关心的是数据、业务逻辑和经验怎么形成能迭代的能力
我理解的数据底座,不是要取代中台、湖仓或知识库,而是把这些技术和管理能力归到一个共同目标底下:长出能被业务反复用、能由数据验证、能跟着新产品和新经验持续改进的模型。
| 比较维度 | 数据中台 | 数据湖仓 | 知识库 | 我们说的数据底座 |
|---|---|---|---|---|
| 主要关注点 | 数据整合、治理、共享与服务 | 存储、处理、查询与分析 | 知识保存、检索与问答 | 数据、业务关系、经验与反馈的统一组织 |
| 核心对象 | 业务数据、主数据、指标、数据服务 | 多类型数据、分析数据集、计算任务 | 文档、规则、案例、知识片段 | 生命周期数据要素、跨阶段关系、业务规则、验证结果 |
| 关键产出 | 可治理、可共享的数据服务 | 可扩展的数据处理和分析能力 | 可查找、可使用的知识内容 | 可验证、可复用、可迭代的模型与知识资产 |
| 典型风险 | 数据汇聚了,但业务语义或责任边界仍不清楚 | 数据存得下、算得动,但不代表业务关系已建立 | 能检索到答案,但知识可能缺少条件、结构或验证 | 如果缺少标准、治理和反馈机制,也可能沦为新的平台名词 |
这张表是按常见实践重点做的概念比较,不是给所有产品的绝对分类。成熟的中台、湖仓、知识平台也可能包含数据建模、语义管理、知识图谱或机器学习能力。真正要比的是一句话:我们的整体方案,有没有把数据标准、跨阶段关联、业务逻辑、专家经验和实际验证闭环连起来。
03落到技术上:这个盘子到底怎么搭
回头看开头说的那个"盘子"。落到技术上,它就是一个符合公司安全、权限、性能、可追溯要求、还能长期演进的数据承载平台。它可以落在我们已有的云平台、数据平台、PLM/MES 体系或者湖仓架构之上,不一定要再采购一套全新的"大平台"。关键不在它叫什么,而在能不能撑住这几件事:统一标识、版本管理、数据血缘、权限控制、跨系统关联、质量检查、持续更新。平台是把东西装下来的能力,替代不了数据标准和业务规则本身。
在这个底座上,再围绕产品开发及其实际生命周期,把要管的数据要素系统梳理一遍。拿我们这种制造企业来说,至少得有这几块:
- 设计数据:产品结构、图纸、三维模型、设计参数、版本、材料规格和配置关系。
- 生产工艺数据:工艺路线、工序、设备条件、加工参数、作业指导和工艺变更。
- 配方与材料数据:配方组成、材料属性、批次、供应商、适用范围及变更记录。
- 模具与工装数据:模具结构、工装配置、寿命、维修、使用条件和关联产品。
- 制造执行数据:生产订单、工序记录、设备状态、实际加工参数、人员与时间信息。
- 质量数据:检验标准、测量结果、缺陷分类、偏差、纠正措施和放行记录。
- 产品应用与运营数据:轨道车辆的实际线路条件、载荷、运行里程、环境工况、架修与大修记录、故障与客户反馈。
- 供应链与追溯数据:供应商、原材料批次、部件批次、交付和替换关系。
对轨道交通装备而言,车辆的运营数据尤其重要。它连接了设计时的假设与车辆在真实线路条件下的表现,能帮我们识别设计参数、制造差异、使用条件和故障结果之间的关联。减振降噪类部件(空气弹簧、橡胶金属件、一系与二系悬挂)的性能表现高度依赖实际工况:线路条件、载荷谱、运行里程、气候环境,都会影响它的寿命与失效模式;而架修、大修这些节点,又提供了难得的实际验证窗口。如果只管设计和生产数据,却没有建立车辆实际运行环境与运行结果的关联,我们就很难形成完整的生命周期反馈。
清单不是一次做完的。先挑业务价值明确、数据基础相对可控的一条产品线或一个关键场景,再慢慢扩。每一类数据都要定义清楚:业务含义、唯一标识、单位、格式、来源、责任人、质量要求、版本规则、更新频率。
04把分散的数据,连成能看懂的关系
标准定完之后,我们要把现有系统里的数据按统一规则接进平台。但数据导入不等于数据治理结束;真正要紧的是确认这些数据能不能准确关联,关联出来有没有业务意义。
这个过程我建议拆成三个层次,互相配合着做。
第一层:先把可追溯的关系理出来
先解决产品、部件、材料、工艺、设备、批次、质量记录和运营对象之间的标识对应。比如,某个质检结果能不能准确追溯到对应的产品序列号、设计版本、生产批次、工艺路线、材料批次?同一个产品在不同系统里的编码,能不能建立可靠映射?一发工程变更,哪些生产批次和质量记录受了影响?
这些关系要建立在日常真实业务记录和可靠标识上,不能只靠名字像、或者文本语义去猜。关键关系还得存下来源、版本、时间、置信依据,方便以后审计复核。
第二层:用统计和模型去"发现"关系
数据质量过了基本要求之后,可以用统计分析、机器学习、实验设计、相关性分析、异常检测这些合适的方法,从海量数据里找值得进一步验证的模式。
比如,某类缺陷是不是总跟某个工艺参数区间、某批材料、某种工况一起出现?某种配置在特定环境下是不是更容易出故障?不同产线的测量分布是不是稳定地有差异?
这里得敲一下黑板:统计相关不等于因果。模型发现的关系只能当候选假设,不能直接当成已经证实的业务规律。样本偏差、测量误差、漏掉的变量、工艺变更,都能把我们带沟里。
第三层:拿业务知识去解释、去交叉验证
模型给了线索,还得结合流程、工程原理和实际情况判断它合不合理。把分析结果和工艺流程、设计约束、实验结果、现场调查、故障复现、专家判断摆在一起对照。
比如发现某参数和缺陷率存在关联,要先查它是不是只是另一个因素的"代理变量",有没有设备差异或产品版本混在里面,再用受控实验、工程验证或后续批次数据去检验。
这一层的产出不是一张好看的图,而是带着明确适用条件、证据来源、验证状态、责任归属的数据关系模型。模型本身也得有状态——"已验证""待验证""已失效",别把暂时发现的规律当成永久规则。
05把老师傅脑子里的东西,变成能复用的资产
我们最有价值的知识,往往不完全写在文件里,而在资深设计师、工艺工程师、质量专家和现场技术人员做判断的那一刻。经验丰富的老师傅知道:某个参数为什么不能超某个范围、某种材料为什么只适合特定工况、某种缺陷通常在什么组合下出现,还有哪些看着像的案例其实不能一刀切处理。
我们要做的,不是把专家经验抄成文字,而是把里头能表达、能验证、能复用的逻辑关系挑出来。可以分这六步走:
- 梳理决策过程:他面对什么问题、用了哪些输入信息、考虑了哪些约束、怎么排除别的方案、最后怎么定的;
- 拆分适用条件:适用什么产品类型、材料、工艺、设备、运行环境和参数范围,例外情形是什么;
- 转成可管理的表达:看知识类型,把经验转成规则表、参数约束、决策树、计算模型、因果假设、知识图谱,或者验证过的案例;
- 和现有数据模型比一比:历史数据支不支持,和统计模型冲不冲突,有没有数据没覆盖到的边界条件;
- 拿试验和实际业务验证:关键规则做仿真、实验、现场验证或历史回测,把验证结果和它的局限都记下来;
- 维护版本和责任:明确规则的负责人、批准状态、适用范围、修改原因和失效条件。
这样沉淀下来的,不是"某位老师傅说过啥",而是能说清依据、适用条件、验证状态、使用边界的业务逻辑。别的工程师看得懂,合适的时候也能被软件、分析模型、AI 工具调用。
这里同样别过度承诺:不是所有经验都能完全形式化,也不是每个专家判断都能立刻被数据验证。隐性知识要靠访谈、现场观察、案例复盘、一起干活慢慢提炼;还没证实的经验,就老老实实标成"假设",别包装成确定规则。
06几个真事:全生命周期数据关系到底值在哪
NIST 做的制造业数字主线研究
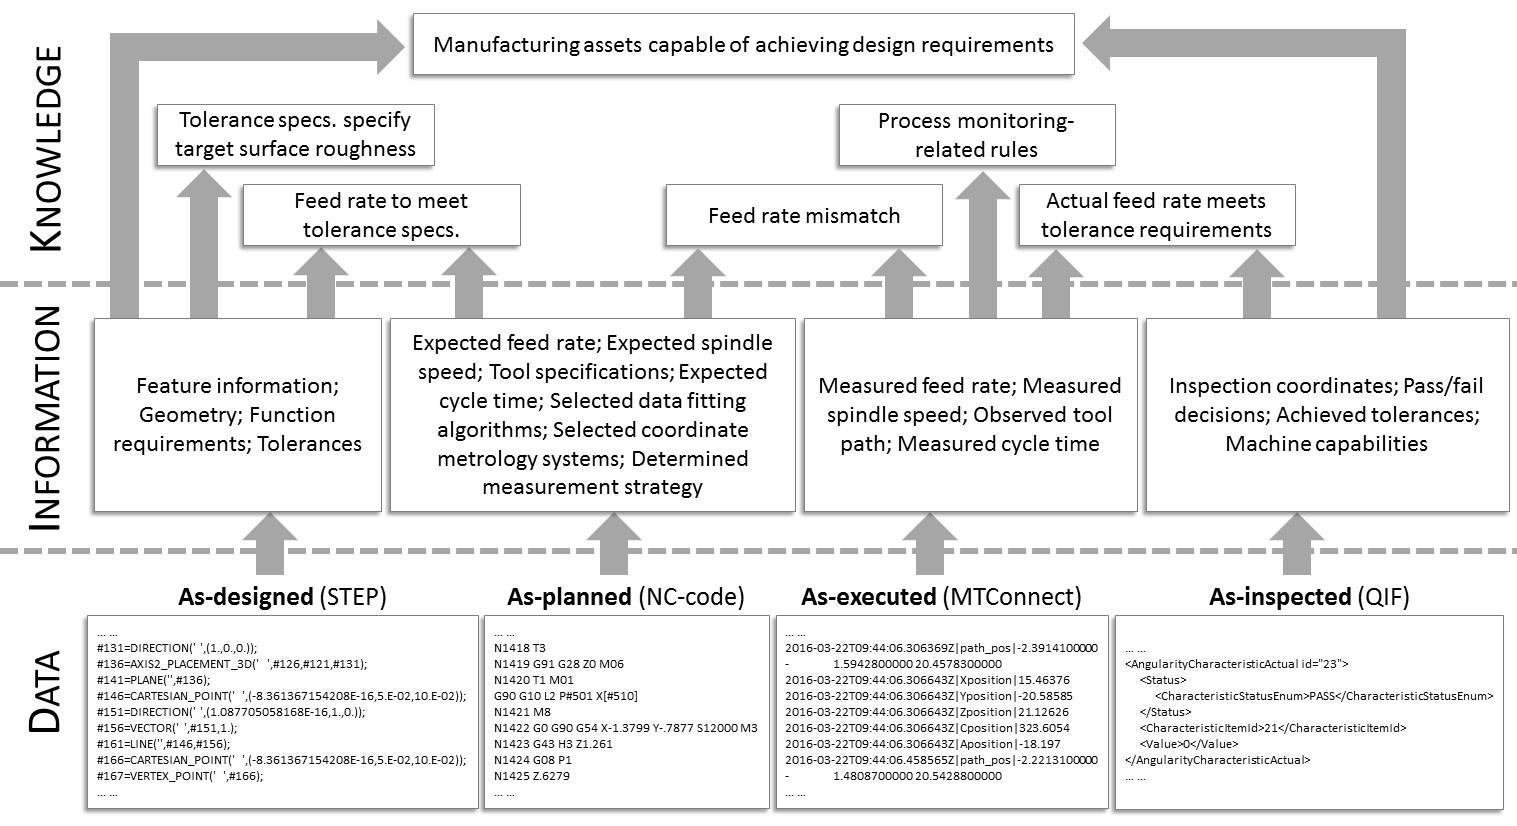
美国国家标准与技术研究院(NIST)长期做制造业"数字主线(Digital Thread)"的研究,关心的是怎么让产品定义、设计、制造、检验、使用各阶段的信息更好地互操作。他们的项目强调用标准、方法、协议、工具来提升产品生命周期信息的质量和可整合性。
在制造场景里,数字主线希望让设计定义、生产计划、实际执行、检验结果之间形成可追溯关联。比如检验和测量结果可以反馈给设计工程师,帮着判断产品是不是符合设计意图、要不要调整设计或制造过程。NIST 的研究也指出,跨生命周期的数据链接能支撑偏差识别、变更请求和纠正建议。
这个例子说明,我们要的不只是把各阶段数据存着,还得保证数据在语义、标识、业务流程上能接起来——这和我前面说的思路是一致的:数据标准、生命周期关联、业务规则、实际反馈,一起构成持续改进的基础。
参考:NIST, Extended Digital Thread;NIST, Digital Thread for Manufacturing;NIST 相关研究论文
Rolls-Royce 与西门子相关的数字主线实践
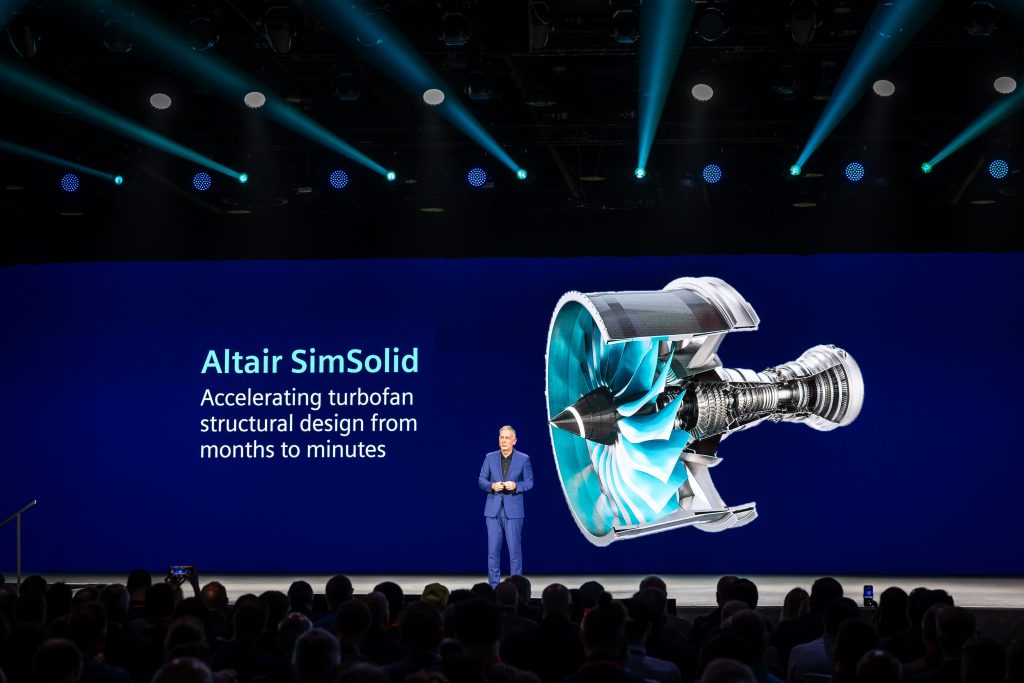
西门子公开的制造业案例里,讲了 Rolls-Royce 怎么把发动机的设计意图、仿真、制造和测试表现连起来——比的是"设计时预期""仿真中表现""实际制造和测试结果",找出差异再反馈回产品开发流程。
它的价值在于展示了跨阶段关系的意义:如果设计、制造、测试数据各管各的,工程团队只能分别扒自己系统里的记录;一旦把产品配置、版本、测试结果可靠地关联上,才有机会把实际表现反馈回设计与制造改进。
参考:Siemens, A New Manufacturing Playbook: Digital Thread, Data Integrity and AI
一家全球生物制药企业的制造数据整合
德勤公开的案例里,把 20 多个制造基地的数据整合起来,涉及 ERP、实验室信息管理系统(LIMS)、质量管理系统(QMS)多个来源,把 150 多个数据实体纳入经过业务语境处理的数据层,用来支撑数据治理和供应链可视性。
这个例子说的是:在复杂组织里,先建一个可治理、可理解、可连接的数据层本身就值钱,能减少不同系统之间的信息割裂,给分析和运营决策一个共同基础。
参考:Deloitte, Optimizing a Global Biopharmaceutical Organization's Supply Chain
07AI 别急着放第一棒
AI 这么热,我们很容易先从聊天机器人、智能问答、自动生成报告或单点预测入手。这些能帮着验证价值,但如果把 AI 工具本身当成了数据底座,忽略数据标准、标识体系、数据质量和业务逻辑,就很容易出现演示效果不错、实际业务用不稳的尴尬。
Gartner 在 2025 年公布过一项调查:面向 1,203 名数据管理领导者,63% 的受访组织表示自己没有、或者不确定有没有适合 AI 的数据管理实践。Gartner 还预测,截至 2026 年,缺乏 AI-ready data 支持的 AI 项目中有 60% 会被放弃。
来源:Gartner, Lack of AI-Ready Data Puts AI Projects at Risk(2025-02-26)
AI 当然不必等我们所有数据标准都完美了才开始试点。反过来,挑边界明确、风险可控的场景,让 AI 帮着整理文档、辅助分类、抽数据、找异常、验证某个具体业务流程,都行。重要的是别把一个局部试点的"能跑",误当成我们企业级的数据基础已经成熟了。
更稳的策略是"双轨推进":
- 底座轨:持续建设数据标准、主数据、数据质量、权限、版本、血缘和跨系统关系;
- 场景轨:选择价值明确的 AI 或分析应用,验证业务效果,把试点里暴露的数据问题反馈回底座建设。
这样既避开了"等所有基础建设完毕才用 AI"的僵化,也避开了"先上 AI、基础问题以后再说"的短视。
08那我们该怎么一步步来
第一阶段:先挑场景和范围
优先选业务价值明确、数据链路能追的产品线、关键部件或质量问题。先想清楚要改善什么——缩短设计选型时间、降低某类缺陷率、减少问题定位时间,还是提高设计变更影响分析的准确性。
第二阶段:把数据要素清单和标准建起来
梳理设计、工艺、材料、模具、生产、质量、运营和维护这些数据要素,定义编码、单位、版本、责任人、来源、质量规则和更新方式。先统一对业务结果影响最大的标识与字段,再逐步扩展,不必一开始就追求覆盖全公司的"大而全"。
第三阶段:连关键数据关系
围绕实际业务问题,建立产品、部件、设计版本、工艺路线、材料批次、质量记录和运营结果之间的关系。关键关系要做抽样核验,确保系统连接反映的是真实业务,而不是只在技术上把字段对上了。
第四阶段:建模型,并且验证它
用统计分析、工程仿真、规则和机器学习等合适的方法发现关系,再结合工艺流程、专家经验和现场证据去验证。每个模型的输入范围、适用条件、验证证据和不确定性,都要记下来。
第五阶段:沉淀专家知识
把关键决策过程转成规则、参数关系、模型和案例资产,标上版本、适用范围与验证状态。建立专家审查和知识维护机制,防止规则随着人员变化或产品迭代而失效。
第六阶段:连上业务应用,形成反馈闭环
把验证过的模型用到设计选型、质量分析、工艺优化、方案设计和 AI 辅助工具里。后续产品的设计、生产、检验和运营数据要持续回流,用来评估模型表现、发现新的边界条件,推动规则和模型更新。
整个过程要有可衡量的指标,比如数据关联成功率、关键字段完整率、质量问题追溯时间、设计变更影响分析时间、模型在新批次上的表现、知识规则复用次数,还有 AI 输出的人工复核通过率。技术指标和业务结果绑在一起,才能判断数据底座到底有没有产出价值。
09怎么判断真建成了,别只看平台上线
平台上线、数据入湖、知识库能问答、AI 演示成功——单独哪一件,都不能证明我们已经有了成熟的数据底座。更有用的判断,是问问自己这几个问题:
- 先回到那个盘子:是不是真有一个大家都在用的地方装着这些数据,而不是各人手上一摊?
- 产品、部件、版本、工艺、批次、质量结果之间,有没有可靠且可追溯的关联?
- 数据标准是被业务系统和日常流程持续执行着,还是只写在规范文件里?
- 模型发现的关系,有没有经过工程知识、实验或实际业务结果验证?
- 专家经验有没有转成带适用条件、版本和责任人的可复用资产?
- 模型和规则能不能被设计、质量、制造和 AI 应用真正调用起来?
- 新产品、新批次和真实运营数据,能不能反馈回来推动模型改进?
- 我们能不能用明确指标证明:问题定位更快了、决策质量更好了、业务成本降了?
这些问题长期答不上来,哪怕平台再先进、AI 工具再多,我们可能还是缺那套真正贯通数据和业务的基础能力。
10收个尾:把数据变成我们能持续复用的能力
数据底座的价值,不在于堆了多少系统、存了多少数据、接了多少 AI 工具,而在于能不能把产品生命周期里的数据要素、跨系统关系、业务逻辑和专家经验组织起来,再用真实业务结果一遍遍验证和更新。
中台、湖仓、知识库各自提供重要的技术和管理能力;数据底座则逼着我们多回答几个问题:这些数据到底在说哪个对象、彼此为什么有关联、关联在什么条件下成立、专家经验能不能被表达和验证、模型能不能被业务反复使用、新的结果怎么反过来修正已有认知。
如果建设顺序长期颠倒——把 AI 的展示效果放在数据标准和业务关系前面——我们可能攒下一堆局部应用,却始终积累不出可持续的知识资产。反过来,以数据承载平台为基础,以标准和关系模型为骨架,以专家 Know-how 为知识来源,以真实产品数据为验证和反馈机制,才更有可能慢慢长出一套可复用、可追溯、可持续迭代的数据底座。
真正值得建设的不是一个新的平台名词,而是一套能让我们不断从数据中学习、验证和改进的机制。
·参考资料与几句说明
- Gartner(2025),Lack of AI-Ready Data Puts AI Projects at Risk。用于说明 AI-ready data 的治理与质量问题,以及 Gartner 对项目风险的预测。这里引用的是趋势判断,不当作已发生的事实。
gartner.com/en/newsroom/press-releases/2025-02-26-lack-of-ai-ready-data-puts-ai-projects-at-risk - NIST,Extended Digital Thread。说明产品生命周期信息互操作、标准和数据整合的重要性。
nist.gov/programs-projects/extended-digital-thread - NIST,Digital Thread for Manufacturing。说明设计、制造与质量活动之间的数字主线。
nist.gov/programs-projects/digital-thread-manufacturing - NIST 研究论文。讨论跨生命周期链接数据、计划与执行信息、偏差识别和纠正建议。
tsapps.nist.gov/publication/get_pdf.cfm?pub_id=920391 - Microsoft Learn / Azure Databricks,What is a lakehouse? 用来界定数据湖仓的技术定位。
learn.microsoft.com/azure/databricks/lakehouse/ - Siemens,A New Manufacturing Playbook: Digital Thread, Data Integrity and AI。这是厂商公开材料,带展示视角,引用时保留归因。
blogs.sw.siemens.com/news/a-new-manufacturing-playbook-digital-thread-data-integrity-and-ai/ - Deloitte,Optimizing a Global Biopharmaceutical Organization's Supply Chain。咨询公司披露的案例,只用来说明多源数据整合这一类做法。
deloitte.com/.../optimizing-a-global-biopharmaceutical-organizations-supply-chain
- "数据底座"是我在工作里用的一个实践性定义,不是行业通用的正式标准术语;
- 表格比的是各类方案的常见侧重点,不是说某类技术绝对做不了别的事;
- NIST 的材料支撑的是技术方向,落到具体公司效果如何,还得看场景和落地质量;
- 西门子和德勤的案例都是对方公开披露的,可能带供应商或咨询项目的展示视角,替代不了我们自己的独立评估;
- Gartner 那个 60% 是预测,不是统计出来的失败率;63% 来自受访组织的自我报告;
- 文中配图都取自对应参考文献的公开网页,版权归原机构(NIST、Microsoft、Siemens、Deloitte)所有,仅用于说明所引用的内容。